IA
Les meilleures solutions et agences d’extraction de documents par IA en France en 2026
Factures, contrats, formulaires, justificatifs : vos équipes ressaisissent encore ce que vos documents contiennent.
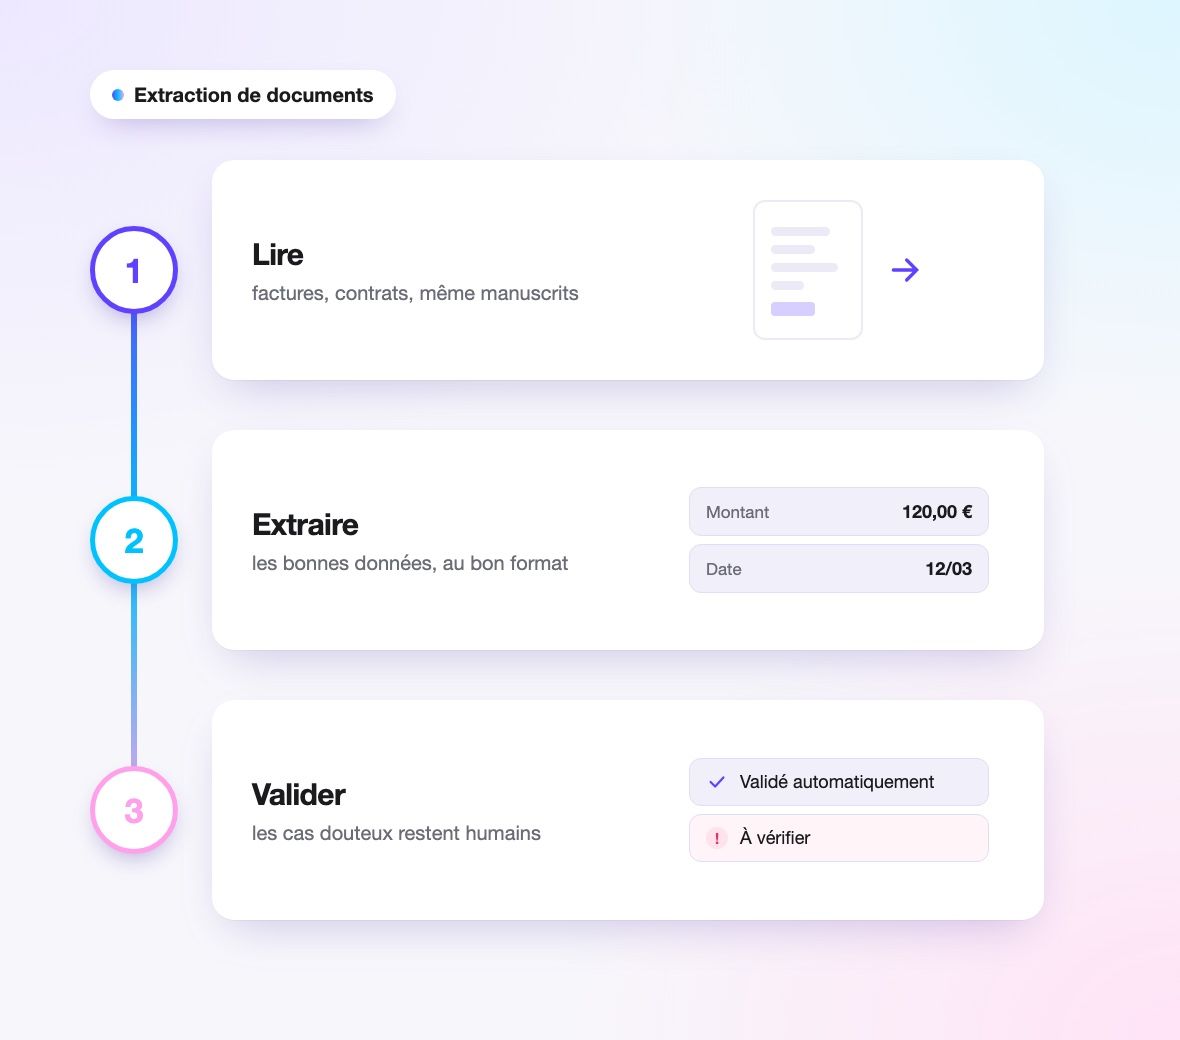
Chez Dernier Cri, nous combinons OCR et modèles d’IA pour extraire automatiquement les bonnes données, y compris sur des documents manuscrits ou mal photographiés.
Nous concevons des chaînes d’extraction sur mesure, évaluées sur vos propres documents avant d’être mises en production.
Concrètement, nous vous aidons à :
Sur un projet récent de factures de médecine douce, souvent manuscrites : moins d’une seconde par facture, 92 % d’extraction fiable et près de 10 % de fraudes détectées, après un banc de test sur 7 000 factures réelles.
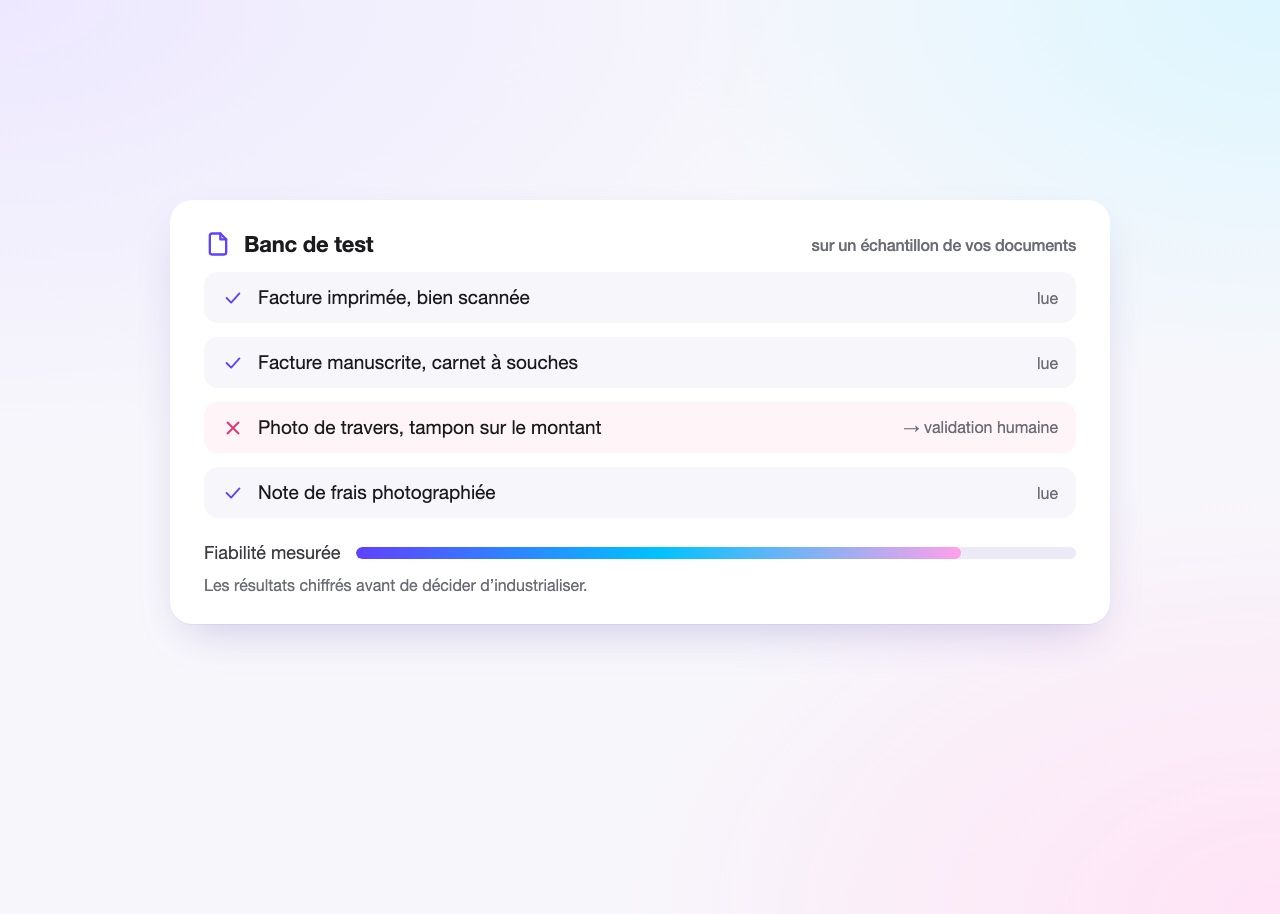
Avant d’écrire une ligne de code, nous construisons un banc de test sur un échantillon de vos documents. Vous savez quelle fiabilité attendre avant d’investir.
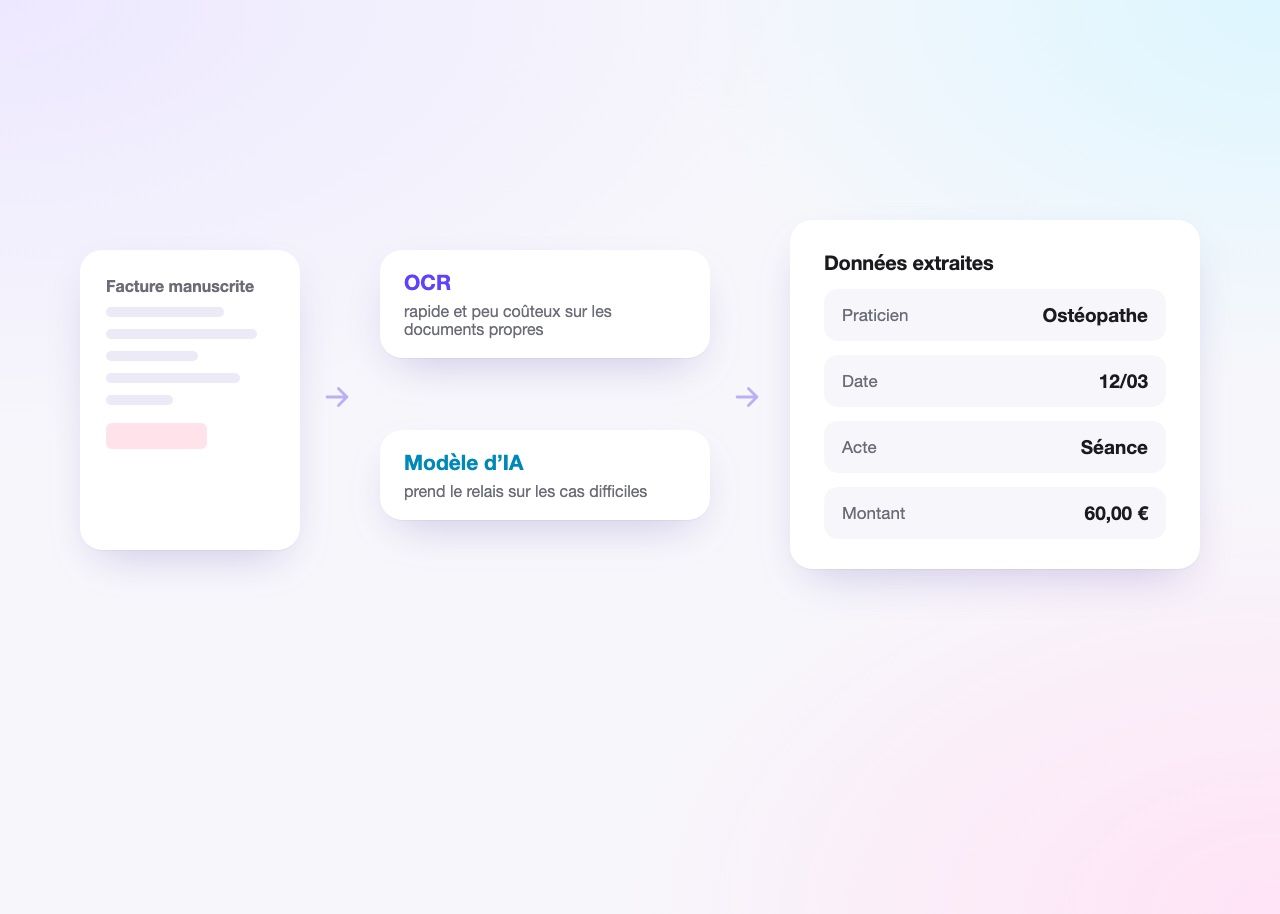
Chaque outil a ses forces. L’OCR lit vite et à bas coût, les modèles d’IA comprennent les documents difficiles. Nous utilisons chacun là où il est le meilleur.
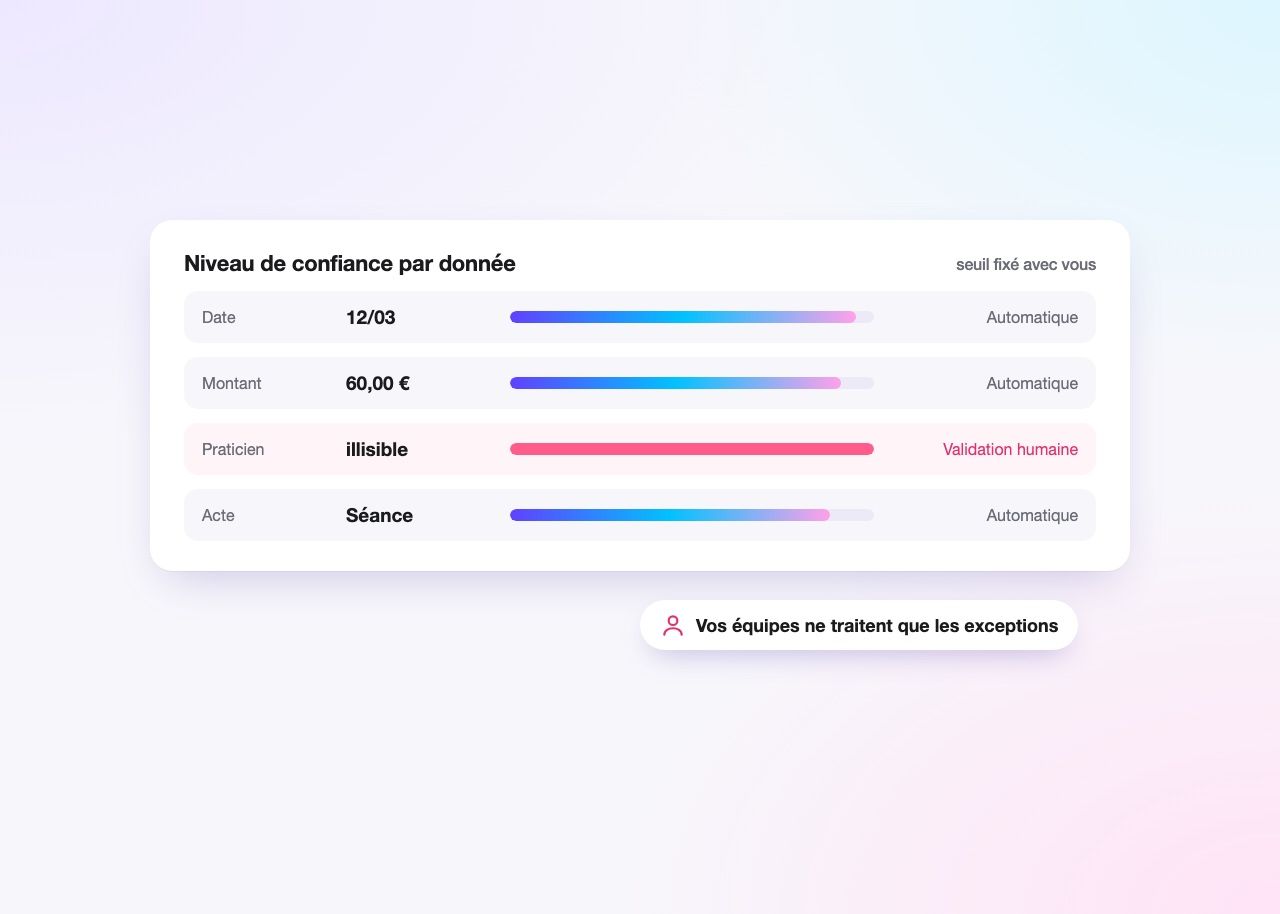
Chaque donnée extraite a un niveau de confiance. En dessous d’un seuil, le document part en validation humaine : vos équipes ne traitent plus que les exceptions.
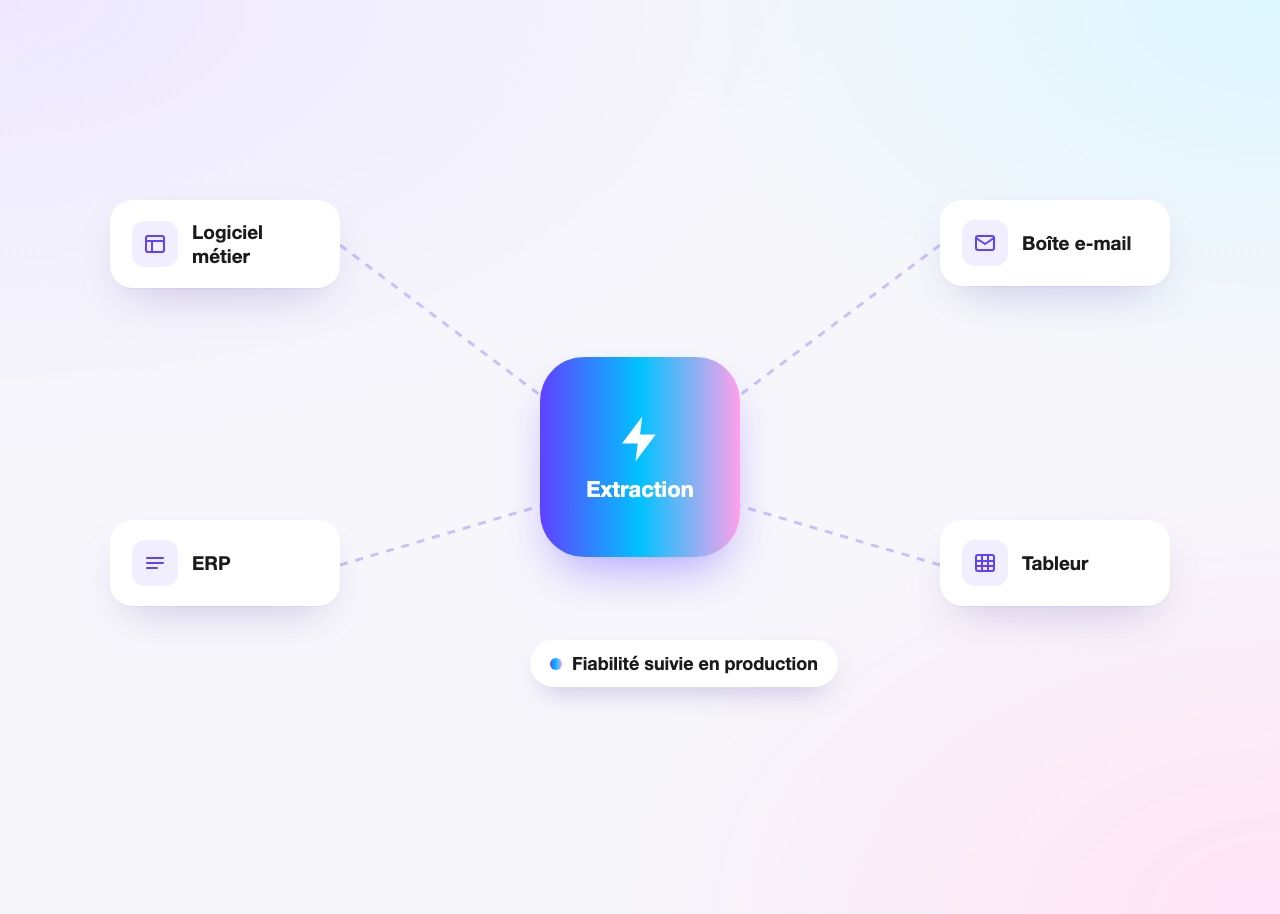
Les données arrivent directement dans vos outils. Nous suivons la fiabilité en production et ajustons quand vos documents évoluent.
Des documents structurés aux plus difficiles à lire.
Fournisseur, montants, TVA, dates, lignes de détail.
Carnets à souches, formulaires remplis à la main, photos prises au téléphone.
Parties, dates clés, montants, clauses à surveiller.
Demandes, dossiers d’adhésion ou de sinistre, pièces justificatives.
Oui, en combinant OCR et modèles d’IA. Sur un projet récent de factures souvent manuscrites, nous avons atteint 92 % d’extraction fiable, les cas douteux partant en validation humaine.
Souvent, oui. L’OCR est rapide et peu coûteux sur les documents propres, les modèles d’IA prennent le relais sur les cas difficiles. La combinaison des deux donne le meilleur rapport fiabilité-coût.
Nous montons un banc de test sur un échantillon de vos documents réels. Vous voyez les résultats chiffrés avant de décider d’industrialiser.
La confidentialité est cadrée dès le départ : choix des modèles et de l’hébergement selon la sensibilité de vos documents.
Oui. Les données extraites alimentent directement votre logiciel métier, votre ERP ou votre outil de gestion.
Cette expertise au service de vos enjeux métier.
Espaces adhérents, plateformes de courtage, parcours de souscription et outils collaborateurs.
Applications financières, outils de pilotage, plateformes de paiement et parcours de souscription.
E-commerce, parcours omnicanaux, applications magasin et services connectés.
Plateformes métiers, espaces clients, outils collaborateurs et services digitaux.
Testons l’extraction automatique sur un échantillon de vos documents.